


- Основные причины сбоев и снижения доступности веб-сайта
- Серверные сбои и нехватка вычислительных ресурсов
- Ошибки программного кода и компонентов сайта
- Проблемы баз данных и хранения информации
- Сетевые неисправности и внешние зависимости
- Контроль доступности, скорости загрузки и основных функций сайта
- Проверка доступности страниц и HTTP-ответов
- Измерение скорости загрузки и времени ответа
- Проверка форм, авторизации и других пользовательских сценариев
- Инструменты для раннего обнаружения технических проблем
- Сервисы внешнего мониторинга и автоматические уведомления
- Мониторинг сервера и программных приложений
- Журналы событий и системы анализа ошибок
- Тестирование после обновлений и изменений конфигурации
- Регулярная диагностика, резервное копирование и восстановление сайта
- Плановое техническое обслуживание
- Резервное копирование файлов и базы данных
- Порядок действий при обнаружении неисправности
- Восстановление из резервной копии и проверка работоспособности
- План восстановления и распределение ответственности
Доступность веб-сайта напрямую влияет на его посещаемость, репутацию компании и эффективность онлайн-продаж. Если страницы долго загружаются, формы перестают отправлять заявки или сайт периодически становится недоступен, пользователи могут отказаться от взаимодействия с ресурсом и перейти к конкурентам. При этом технические сбои не всегда проявляются сразу: небольшая ошибка в программном коде, нехватка ресурсов сервера или постепенное увеличение нагрузки способны долго оставаться незаметными, пока не приведут к серьёзным последствиям.
Чтобы поддерживать стабильную работу сайта, недостаточно время от времени открывать главную страницу и проверять, отображается ли она в браузере. Необходим комплексный подход, включающий наблюдение за доступностью, контроль скорости загрузки, проверку основных функций, анализ серверных журналов и своевременное устранение неисправностей. Важную роль играют автоматизированные инструменты мониторинга, регулярная диагностика и проверенная система резервного копирования. Всё это позволяет обнаруживать проблемы на ранней стадии, сокращать время простоя и поддерживать работоспособность веб-ресурса даже при возникновении технических неполадок.
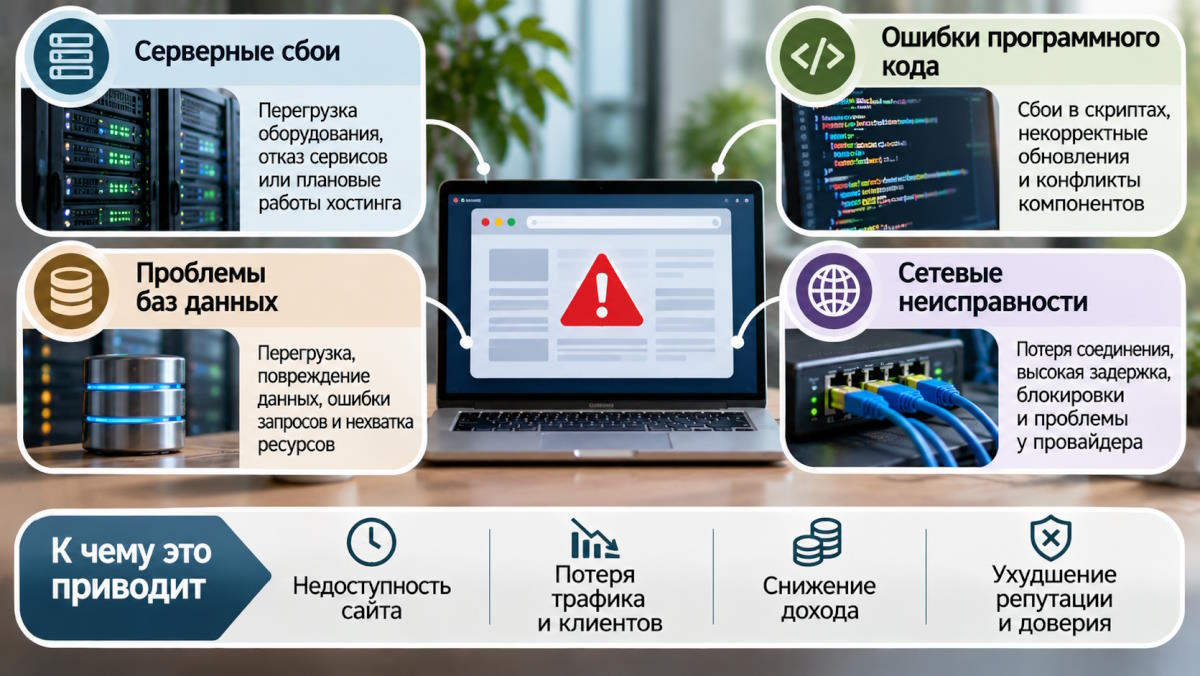
Основные причины сбоев и снижения доступности веб-сайта
Стабильность сайта зависит от взаимодействия нескольких компонентов: сервера, программного кода, базы данных, сетевой инфраструктуры и внешних сервисов. Неисправность любого из них может повлиять на работу ресурса целиком или отдельных функций. Поэтому при диагностике важно учитывать не только видимые ошибки в браузере, но и состояние всей технической системы.
Серверные сбои и нехватка вычислительных ресурсов
Одна из распространённых причин недоступности сайта — проблемы с сервером, на котором размещены его файлы и приложения. Это может быть аппаратная неисправность, отказ дисковой подсистемы, сбой оперативной памяти, проблемы с питанием или перегрузка виртуальной машины. В результате веб-сервер перестаёт отвечать на запросы, страницы открываются с большой задержкой или пользователи получают сообщения об ошибках.
Даже если оборудование работает исправно, сайт может столкнуться с нехваткой ресурсов. Например, при резком увеличении посещаемости возрастает нагрузка на процессор, оперативную память и дисковую подсистему. Если выделенных мощностей недостаточно, обработка запросов замедляется, а при достижении критических ограничений сервисы могут перестать отвечать. Подобная ситуация встречается во время рекламных кампаний, распродаж, публикации популярных материалов и других событий, вызывающих всплеск трафика.
Отдельного внимания заслуживают настройки серверного программного обеспечения. Неправильно настроенные лимиты соединений, недостаточное количество рабочих процессов, ошибки конфигурации Apache или Nginx и проблемы с PHP-FPM могут ограничивать производительность даже при наличии свободных аппаратных ресурсов. Поэтому диагностика должна учитывать не только загрузку сервера, но и параметры работы служб, отвечающих за обработку запросов.
Ошибки программного кода и компонентов сайта
Сайт может оставаться доступным на уровне сервера, но отдельные страницы или функции перестают работать из-за ошибок в программном коде. Например, после обновления CMS, установки плагина или изменения шаблона возникает конфликт между компонентами. В результате пользователь видит пустую страницу, некорректную разметку, сообщение об ошибке или не может выполнить нужное действие.
Проблемы также возникают из-за устаревших библиотек, несовместимых версий PHP, неправильных настроек окружения и ошибок при обращении к сторонним API. Иногда неисправность проявляется только при определённых условиях: например, когда посетитель авторизуется, отправляет форму, добавляет товар в корзину или оформляет заказ. Поэтому простая проверка главной страницы не позволяет оценить работоспособность всего сайта.
Особенно опасны ошибки, которые не приводят к полному отказу ресурса, но нарушают важные пользовательские сценарии. Интернет-магазин может открываться без проблем, однако не принимать оплату. Сайт компании может отображать страницы, но не отправлять заявки из формы обратной связи. Такие неисправности способны приводить к потере клиентов, оставаясь незаметными для владельца ресурса.
Проблемы баз данных и хранения информации
База данных обеспечивает работу многих динамических сайтов: в ней хранятся пользователи, публикации, товары, заказы, настройки и другие сведения. Если сервер базы данных становится недоступен, сайт может перестать отображать содержимое или полностью прекратить обработку запросов. Даже кратковременные перебои способны вызвать ошибки авторизации, сбои при сохранении информации и нарушения работы административной панели.
Причиной проблем могут быть исчерпание свободного места, высокая нагрузка, блокировки запросов, повреждение таблиц, ошибки индексов и неправильная конфигурация СУБД. Например, неоптимизированный запрос способен долго обрабатывать большой объём данных, занимать ресурсы и замедлять работу других операций. При увеличении количества посетителей подобные недостатки проявляются особенно заметно.
Важно следить не только за доступностью базы данных, но и за её производительностью. Время выполнения запросов, количество активных соединений, использование дискового пространства и наличие ошибок в журналах помогают обнаруживать потенциальные проблемы до того, как они приведут к отказу сайта. Также необходимо контролировать свободное место на дисках, поскольку заполненное хранилище может нарушить работу не только базы данных, но и всего сервера.
Сетевые неисправности и внешние зависимости
Даже исправный сервер не гарантирует доступность сайта, если возникают проблемы с сетевым подключением. Перебои у провайдера, неисправности маршрутизации, ошибки DNS, сбои сетевого оборудования и проблемы с защитными фильтрами могут препятствовать установлению соединения между пользователем и веб-ресурсом.
Отдельный фактор — работа внешних сервисов. Сайт может использовать сторонние системы оплаты, авторизации, доставки электронной почты, аналитики, CAPTCHA или загрузки контента. Если один из таких компонентов становится недоступен, соответствующая функция перестаёт работать, хотя сам веб-сервер продолжает отвечать на запросы. Иногда внешняя зависимость влияет на весь сайт, если программный код ожидает ответа от сторонней системы и не обрабатывает задержки или ошибки корректно.
Для снижения подобных рисков важно отслеживать не только собственную инфраструктуру, но и критически важные внешние компоненты. Также желательно предусматривать альтернативные сценарии работы: например, ограниченный режим обслуживания при недоступности дополнительного сервиса, повторные запросы с разумными интервалами и понятные сообщения пользователям.
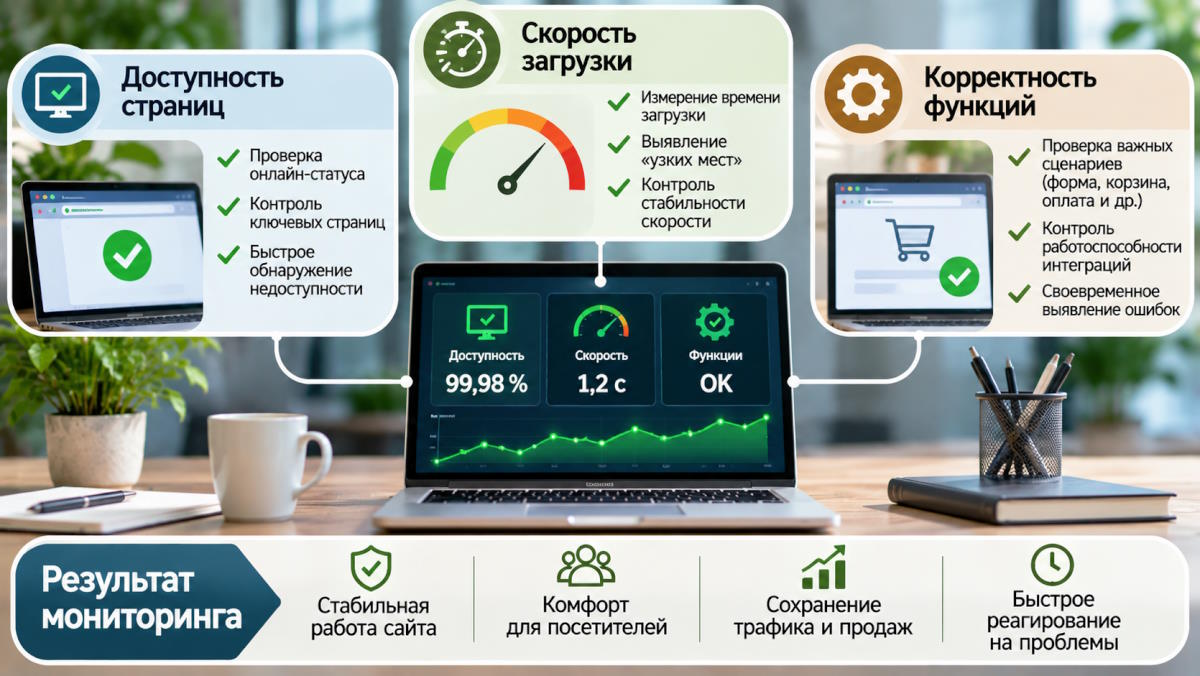
Контроль доступности, скорости загрузки и основных функций сайта
Регулярный мониторинг позволяет оценивать состояние веб-ресурса не только в момент возникновения проблем, но и в обычном режиме работы. Для этого необходимо отслеживать несколько групп показателей: доступность страниц, скорость ответа сервера, время загрузки контента и корректность выполнения пользовательских сценариев. Комплексная проверка помогает отличить временные сетевые задержки от серьёзных технических неисправностей и быстрее определить источник проблемы.
Проверка доступности страниц и HTTP-ответов
Базовый уровень мониторинга — регулярная проверка доступности сайта. Специальный сервис или скрипт периодически отправляет HTTP- или HTTPS-запросы на заданный адрес и анализирует полученный ответ. Если сервер возвращает ожидаемый статус, например HTTP 200, проверка считается успешной. Коды 404, 500, 502, 503 и другие позволяют обнаружить определённые проблемы, хотя сами по себе не всегда указывают на конкретную причину неисправности.
Проверять желательно не только главную страницу, но и несколько важных разделов. Например, для интернет-магазина это могут быть каталог, карточка товара, корзина и страница оформления заказа. Для корпоративного сайта — раздел услуг, контакты и формы обратной связи. Такой подход помогает обнаруживать ситуации, когда ресурс доступен в целом, но отдельные страницы работают неправильно.
Периодичность проверок зависит от назначения сайта и требований к его доступности. Для небольшого информационного ресурса может быть достаточно нескольких проверок в течение часа, а для интернет-магазина или сервиса, работающего с заказами, желательно использовать более частый контроль. При этом важно учитывать ограничения хостинга и не создавать избыточную нагрузку большим количеством однотипных запросов.
Измерение скорости загрузки и времени ответа
Доступность сайта не всегда означает, что он работает комфортно. Страница может открываться, но загружаться настолько медленно, что пользователь не дождётся её отображения. Поэтому необходимо контролировать время ответа сервера и скорость загрузки основных элементов интерфейса.
Один из важных показателей — TTFB (Time to First Byte), то есть время от отправки запроса до получения первого байта ответа. Он помогает оценить скорость реакции сервера, хотя зависит не только от производительности приложения, но и от сетевых условий. Если этот показатель регулярно увеличивается, стоит проверить загрузку сервера, работу базы данных, обработку PHP-скриптов и настройки кэширования.
Для оценки пользовательского опыта Google использует показатели Core Web Vitals. Среди них особое значение имеют:
- LCP (Largest Contentful Paint) — время отображения крупнейшего видимого элемента страницы.
- INP (Interaction to Next Paint) — оценка отзывчивости интерфейса на действия пользователя.
- CLS (Cumulative Layout Shift) — показатель визуальной стабильности, отражающий неожиданные смещения элементов.
Для хорошего пользовательского опыта Google рекомендует ориентироваться на LCP не более 2,5 секунды, INP не более 200 миллисекунд и CLS не более 0,1. Оценка проводится по данным реальных посещений с учётом 75-го процентиля, поэтому единичный быстрый тест не гарантирует, что все пользователи получают одинаково комфортный опыт.
Проверка форм, авторизации и других пользовательских сценариев
Отдельная задача — убедиться, что сайт не просто отображает страницы, а выполняет предусмотренные функции. Для этого проверяют формы обратной связи, регистрацию, авторизацию, поиск, фильтрацию товаров, добавление в корзину и другие важные операции. В зависимости от назначения ресурса набор тестов может существенно различаться.
Например, на сайте компании полезно периодически проверять отправку тестовой заявки и поступление уведомления на электронную почту. В интернет-магазине необходимо контролировать работу корзины, расчёт стоимости заказа и взаимодействие с платёжной системой. На информационном портале можно проверять поиск, переходы между разделами и отображение материалов.
Такие проверки называют функциональным мониторингом. Они позволяют обнаружить ошибки, которые не видны при обычном запросе главной страницы. Для автоматизации используют специальные сценарии, имитирующие действия посетителя в браузере. При этом тесты желательно выполнять в безопасной среде или с тестовыми данными, чтобы не создавать реальные заказы, не отправлять лишние сообщения и не изменять информацию пользователей.
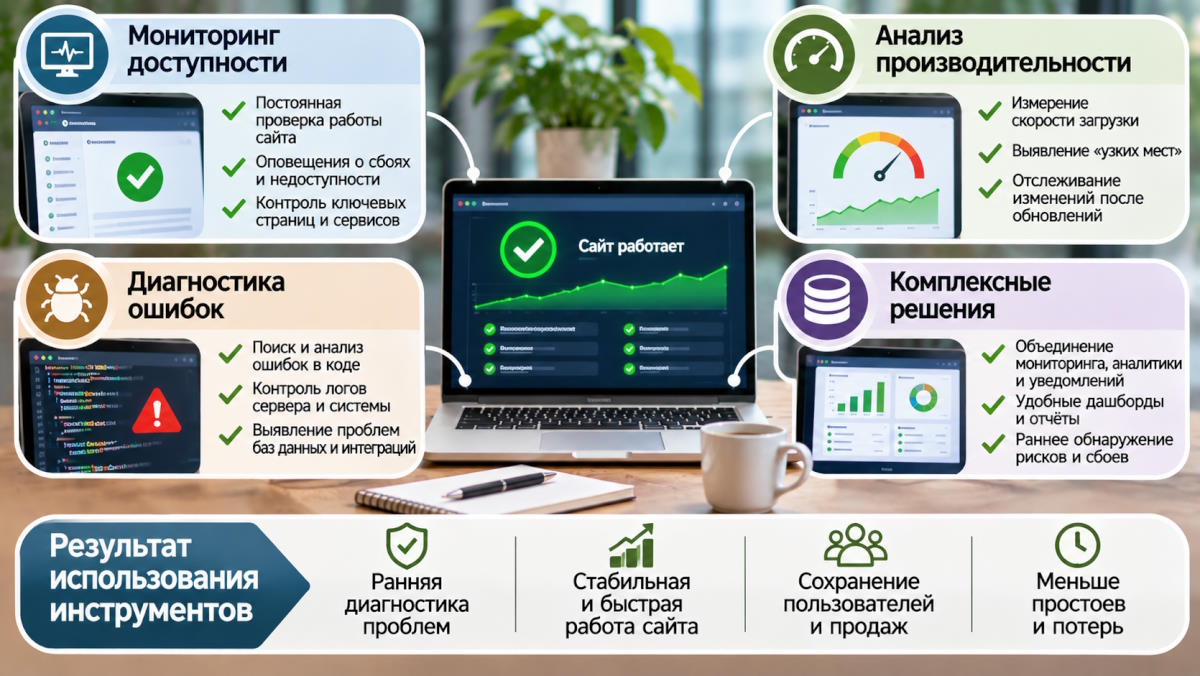
Инструменты для раннего обнаружения технических проблем
Эффективный мониторинг строится на сочетании нескольких инструментов. Одни проверяют доступность сайта извне, другие анализируют серверные ресурсы, третьи собирают сведения о работе программного кода и отдельных приложений. Чем лучше эти данные связаны между собой, тем быстрее можно определить причину сбоя и принять необходимые меры.
Сервисы внешнего мониторинга и автоматические уведомления
Внешний мониторинг позволяет проверять сайт из независимой точки, не используя инфраструктуру самого ресурса. Специализированный сервис отправляет запросы с заданной периодичностью, фиксирует время ответа и сообщает о недоступности. Некоторые решения поддерживают проверку из нескольких географических регионов, что помогает отличить локальную сетевую проблему от общего отказа веб-сервера.
Для небольших проектов можно использовать простые сервисы проверки доступности по HTTP или ICMP, а также собственные скрипты, которые периодически обращаются к заданному адресу. Более функциональные платформы позволяют контролировать несколько URL, анализировать историю доступности, строить графики и настраивать разные сценарии уведомлений.
Оповещения могут поступать по электронной почте, в мессенджер или через другие каналы. Важно настроить их так, чтобы сообщения приходили ответственным сотрудникам, а не только владельцу сайта. При этом желательно предусмотреть повторную проверку перед отправкой тревожного уведомления: единичный неудачный запрос может быть вызван кратковременным сетевым сбоем и не всегда означает реальную недоступность ресурса.
Мониторинг сервера и программных приложений
Для выявления внутренних причин неисправностей необходим контроль состояния серверной инфраструктуры. Обычно отслеживают загрузку процессора, использование оперативной памяти, дисковое пространство, дисковую активность, сетевой трафик и количество активных соединений. Эти показатели помогают заметить постепенное увеличение нагрузки и определить, какие ресурсы становятся ограничивающим фактором.
Не менее важен мониторинг приложений: решение для мониторинга приложений позволяет отслеживать состояние веб-сервисов, время обработки запросов, ошибки выполнения, производительность отдельных компонентов и взаимодействие с базами данных или внешними API. Например, если сайт начинает медленно отвечать из-за длительного выполнения определённого запроса, система наблюдения может помочь выявить проблемный участок приложения. При появлении ошибок или отклонений от заданных показателей ответственные специалисты своевременно получают уведомления.
Особенно полезен такой подход для проектов со сложной архитектурой, где работа сайта зависит от нескольких взаимосвязанных сервисов. Вместо того чтобы вручную проверять каждый компонент, специалисты получают общую картину состояния системы и могут быстрее определить, на каком этапе возникает задержка или отказ. При выборе инструмента важно учитывать поддержку используемых языков программирования, серверных платформ, баз данных и способов интеграции с существующей инфраструктурой.
Журналы событий и системы анализа ошибок
Логи — один из основных источников информации при диагностике веб-сайта. В них фиксируются обращения к серверу, ошибки приложений, предупреждения, события авторизации и другие технические сведения. Анализ журналов помогает установить, когда возникла неисправность, какие действия ей предшествовали и какие компоненты участвовали в обработке запроса.
В первую очередь полезно контролировать журналы веб-сервера, PHP, базы данных и самой CMS. Например, ошибки 500 могут сопровождаться сообщениями о фатальных ошибках PHP, превышении допустимого времени выполнения скрипта или проблемах с доступом к файлам. Код 502 иногда связан с тем, что веб-сервер не получил корректный ответ от PHP-FPM или другого приложения. Однако конкретную причину необходимо устанавливать по журналам и текущему состоянию инфраструктуры, а не только по коду ответа.
Для работы с большим объёмом логов используют централизованные системы сбора и анализа событий. Они позволяют объединять записи с нескольких серверов, искать повторяющиеся ошибки, фильтровать сообщения по времени и компонентам, а также выявлять аномалии. Это особенно удобно для проектов, где отдельные части сайта размещены на разных виртуальных машинах или взаимодействуют через API.
Тестирование после обновлений и изменений конфигурации
Многие неисправности возникают после технических изменений. Обновление CMS, установка расширения, изменение версии PHP, перенос сайта на другой сервер или корректировка конфигурации могут повлиять на совместимость компонентов. Поэтому перед внесением изменений желательно создавать резервную копию и проверять обновления на тестовой площадке.
После установки обновлений необходимо протестировать основные страницы и пользовательские сценарии. Важно убедиться, что сайт корректно отображается на разных устройствах, формы отправляют данные, авторизация работает, а база данных обрабатывает запросы без ошибок. Для крупных проектов полезно использовать автоматические тесты, которые запускаются после внесения изменений и проверяют ключевые функции.
Также стоит вести журнал технических изменений. В нём фиксируют даты обновлений, изменённые компоненты, настройки и результаты тестирования. Если после очередного изменения сайт начинает работать нестабильно, такая история помогает быстрее определить возможную причину и при необходимости вернуться к предыдущей конфигурации.
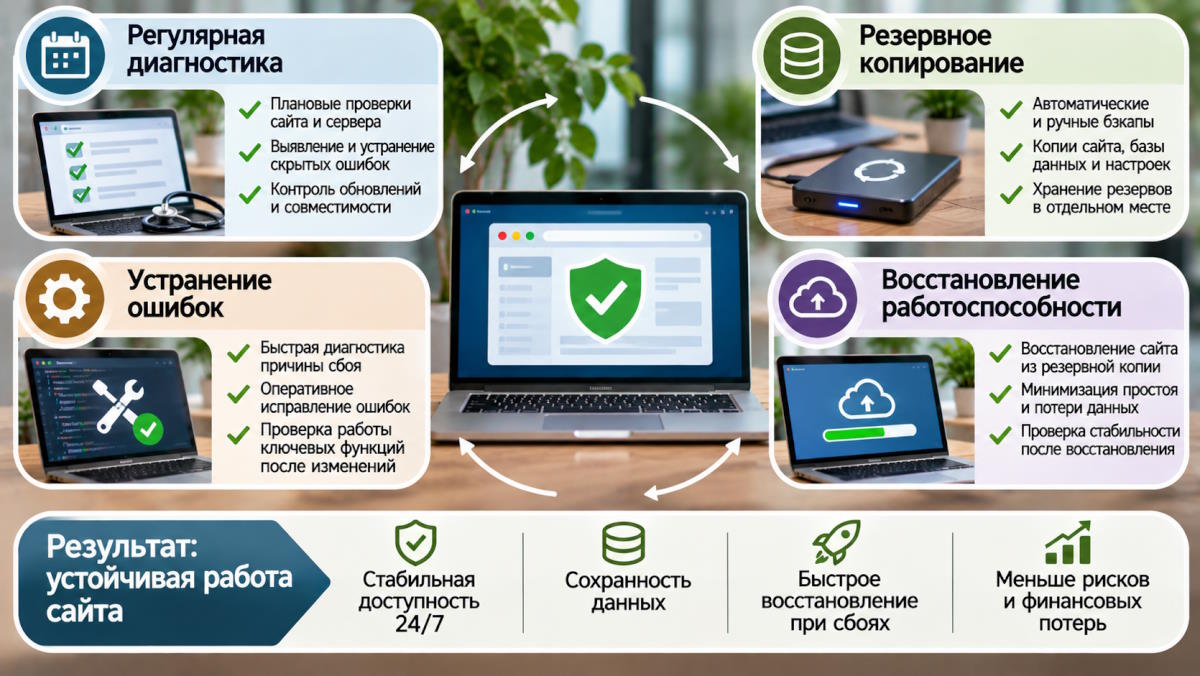
Регулярная диагностика, резервное копирование и восстановление сайта
Даже хорошо настроенная система мониторинга не исключает технических отказов. Она помогает своевременно обнаруживать проблемы, но для сохранения данных и быстрого восстановления необходим отдельный план обслуживания. Регулярная диагностика, резервное копирование и заранее подготовленные сценарии реагирования позволяют уменьшить последствия неисправностей и избежать длительного простоя.
Плановое техническое обслуживание
Диагностику сайта желательно проводить по установленному графику, а не только после появления ошибок. В рамках регулярного обслуживания проверяют состояние сервера, свободное место на дисках, актуальность программного обеспечения, работу базы данных и корректность основных функций. Частота проверок зависит от масштаба проекта, интенсивности обновлений и требований к доступности.
Особое внимание стоит уделять программной платформе. Необходимо своевременно устанавливать обновления CMS, плагинов, библиотек, веб-сервера и других компонентов. При этом не следует без предварительной проверки обновлять все элементы на рабочем сайте одновременно. Гораздо безопаснее сначала проверить совместимость на тестовой копии, создать резервную точку и только после этого переносить изменения в рабочую среду.
Полезно также периодически проверять конфигурацию сервера и права доступа к файлам. Неправильные разрешения, устаревшие учётные записи и ненужные службы могут создавать не только технические, но и информационные риски. Плановое обслуживание должно включать проверку сертификатов TLS, домена, DNS-записей и сроков действия внешних сервисов, от которых зависит работа сайта.
Резервное копирование файлов и базы данных
Резервная копия позволяет восстановить сайт после случайного удаления файлов, неудачного обновления, повреждения базы данных или серьёзного сбоя сервера. Однако важно понимать, что наличие одной копии на том же сервере не обеспечивает полноценной защиты. Если оборудование выйдет из строя или доступ к хранилищу будет потерян, резервные данные могут оказаться недоступными вместе с основным ресурсом.
Надёжная схема предполагает хранение нескольких копий в разных местах. Например, одна может находиться на основном сервере для быстрого восстановления отдельных файлов, другая — в удалённом хранилище, а третья — на независимом носителе. При выборе схемы полезно ориентироваться на принцип 3-2-1: иметь три экземпляра данных, хранить их на двух разных типах носителей и одну копию размещать отдельно от основной инфраструктуры.
Резервировать нужно не только файлы сайта, но и базу данных. Для динамических ресурсов она может содержать наиболее важную информацию: заказы, заявки, учётные записи, настройки и публикации. Частота копирования зависит от того, насколько часто обновляются данные и сколько информации допустимо потерять при аварии. Для активно работающего интернет-магазина резервные копии базы могут требоваться значительно чаще, чем для сайта с редко обновляемыми материалами.
При этом необходимо контролировать успешность создания копий. Сам факт запуска резервного задания ещё не означает, что архив сформирован корректно. Желательно проверять результаты выполнения, контролировать размер файлов и периодически проводить тестовое восстановление.
Порядок действий при обнаружении неисправности
Когда система мониторинга сообщает о проблеме, важно не начинать хаотично менять настройки сервера или удалять подозрительные компоненты. Сначала необходимо определить масштаб неисправности: недоступен весь сайт, отдельная страница или конкретная функция. Затем проверяют доступность сервера, состояние веб-служб, базу данных, сетевые соединения и последние записи в журналах.
Если проблема возникла после обновления или изменения конфигурации, стоит сопоставить время появления ошибки с журналом технических работ. Это поможет определить, связано ли нарушение с последними изменениями. При необходимости можно временно отключить проблемный компонент, вернуть предыдущую версию конфигурации или восстановить файлы из проверенной резервной копии.
Важно также учитывать влияние неисправности на пользователей. Если сайт недоступен длительное время, можно разместить страницу технического обслуживания с кратким объяснением ситуации и информацией о восстановлении. Для интернет-магазинов и сервисов, обрабатывающих заказы, особенно важно сохранить поступившие данные и не допустить повторной обработки платежей или заявок после возвращения системы в рабочее состояние.
Восстановление из резервной копии и проверка работоспособности
Перед восстановлением желательно определить, какие именно компоненты повреждены. Если проблема касается одного файла или расширения, полное развёртывание резервной копии может оказаться избыточным. В других ситуациях, например при повреждении базы данных или серьёзном отказе сервера, может потребоваться восстановление всего проекта на чистой инфраструктуре.
После возврата файлов и базы данных необходимо проверить совместимость версий программного обеспечения, корректность конфигурации, права доступа и подключение к внешним сервисам. Затем тестируют главную страницу, внутренние разделы, формы, авторизацию, поиск и другие важные функции. Для интернет-магазина дополнительно проверяют корзину, создание заказа и взаимодействие с платёжным шлюзом в безопасном тестовом режиме.
Не стоит считать восстановление завершённым сразу после того, как главная страница открылась в браузере. Нужно убедиться, что данные актуальны, пользовательские операции выполняются корректно, а ошибки не повторяются. После этого следует проверить работу мониторинга и убедиться, что система снова отправляет уведомления о критических событиях.
План восстановления и распределение ответственности
Для сайтов, от которых зависит работа бизнеса, полезно заранее подготовить план аварийного восстановления. В нём указывают порядок действий при различных типах отказов, ответственных сотрудников, расположение резервных копий, доступы к необходимым системам и контакты технических специалистов. Это сокращает время на принятие решений в стрессовой ситуации и снижает вероятность ошибок при восстановлении.
При планировании можно использовать два важных показателя. Первый — RTO (Recovery Time Objective), то есть целевое время восстановления сервиса после сбоя. Второй — RPO (Recovery Point Objective), допустимый интервал потери данных, выраженный во времени. Например, если компания устанавливает RPO в один час, резервирование должно быть организовано так, чтобы при аварии потеря последних изменений не превышала этот период.
Значения RTO и RPO определяются назначением сайта, допустимыми финансовыми потерями и техническими возможностями инфраструктуры. Для небольшого информационного ресурса восстановление в течение нескольких часов может быть приемлемым. Для интернет-магазина, платёжного сервиса или корпоративной системы даже короткий простой способен привести к существенным последствиям, поэтому требования к резервированию и восстановлению должны быть строже.
***
Бесперебойная работа веб-сайта зависит от состояния всей технической инфраструктуры: сервера, программного кода, базы данных, сетевых соединений и внешних сервисов. Даже если главная страница открывается без ошибок, это ещё не гарантирует корректную работу форм, авторизации, поиска и других важных функций. Поэтому полноценный контроль должен охватывать не только доступность ресурса, но и скорость ответа, производительность приложений и выполнение пользовательских сценариев.
Автоматизированный мониторинг помогает обнаруживать неисправности до того, как они приведут к серьёзным последствиям. Внешние проверки показывают, доступен ли сайт для посетителей, серверные инструменты позволяют оценивать загрузку инфраструктуры, а системы мониторинга приложений и анализа журналов помогают выявлять ошибки внутри программных компонентов. При этом важно правильно настроить уведомления, чтобы ответственные специалисты получали информацию о действительно значимых событиях.
Не менее важны регулярное техническое обслуживание, резервное копирование и проверенный план восстановления. Если заранее определить порядок действий при сбоях, контролировать сохранность данных и периодически тестировать резервные копии, последствия аварийных ситуаций будут значительно менее серьёзными. Комплексный подход позволяет не только быстрее устранять ошибки, но и поддерживать стабильность веб-ресурса, сохранять доверие пользователей и снижать риски для бизнеса.
